入选 ACM Multimedia 2026 Oral:江行智能研究成果Toruk 让三维实景交互应用更进一步
三维重建让真实世界得以更加逼真地呈现在数字空间中。但当一座城市、一片园区或一个工业场站被完整重建后,人们能否通过网络随时进入其中,自由观察、持续探索?
高保真的场景表达,是开展远程协作、工业现场复盘和虚拟演练的基础。随着场景规模不断扩大,如何适应变化的网络条件,及时传输所需内容、保障持续观察与交互,成为三维实景走向应用需要解决的问题。
近日,由南开大学、江行智能等相关研究人员共同完成的论文《Toruk: Spatially Adaptive Large-Scale 3DGS Scene Streaming for Photorealistic Interactive Virtual Walkthrough》入选 ACM Multimedia 2026 Oral。
该研究提出Toruk空间自适应流传输系统,通过协同设计场景表示、内容预取和传输决策,探索如何在动态网络条件下实现大规模三维实景的高保真交互,为进一步利用真实环境数据提供技术基础。
从“重建一个空间”到“持续使用一个空间”,不仅要提升视觉质量,还要解决数据组织、网络传输和交互响应等方面的系统性挑战。
真实世界被重建之后,如何真正用起来?
近年来,三维高斯泼溅(3D Gaussian Splatting,简称 3DGS)技术推动了真实场景的高保真重建的发展。
3DGS 使用大量具有位置、形状、颜色和透明度等属性的高斯基元来表达环境,让使用者能够从不同位置和角度观察丰富的场景细节。但当重建范围从单个物体扩展到整片区域时,数据规模也会迅速增长。
即使经过压缩,大规模三维场景仍可能达到GB 级。如果每次访问都要等待完整模型下载,远程交互就难以快速开始;如果只加载当前视野中的内容,又可能无法及时满足使用者接下来的移动需求。例如,远程查看工业场站时,工程师可能先观察整体布局,再沿通道进入设备区域,随后调整视角检查周边环境。
随着观察位置变化,所需数据的范围与精度也会随之改变。普通视频按照时间顺序播放,系统可以提前缓存“接下来几秒”的内容。三维漫游的访问顺序却由使用者决定:前进、转身、停留或折返,都会改变下一步的数据需求。因此,要实现高质量的三维交互,场景内容需要跟随使用过程及时传输到位。 场景如何划分、哪些区域应该提前加载、有限带宽如何分配,都直接影响最终体验。
Toruk 正是围绕这些问题展开研究。
组织空间:让大规模场景可以分块、分层、按需访问
要让三维场景适合网络传输,首先需要解决如何组织数据。一种直观的做法,是将场景划分为小块,再按需加载。但三维高斯基元共同参与画面合成,如果直接按位置切割,容易影响区域边界和整体视觉一致性;如果只是简单减少基元数量,也难以兼顾数据体积与画面质量。
为此,Toruk提出了一种局部与全局交叉协同的三维高斯分割及分层表示方法。系统结合采集轨迹与场景几何划分空间单元,并以粗粒度的全局表示提供结构参照,随后交替进行局部优化与全局微调,为各个区域构建基础层和增强层。
基础层呈现场景的基本视觉内容,增强层则逐步补充细节。不同区域可以采用不同质量层级,最终共同组成完整画面。这样,系统就能根据观察需求安排传输:先为远处区域提供基本内容,再为近处区域逐步加载更多细节,同时兼顾不同区域之间的视觉一致性。由此,庞大的三维重建结果被组织成可逐步获取的空间内容。 对于覆盖范围广、区域数量多的实景数据,这种组织方式为后续的远程访问和重复利用提供了更灵活的基础。
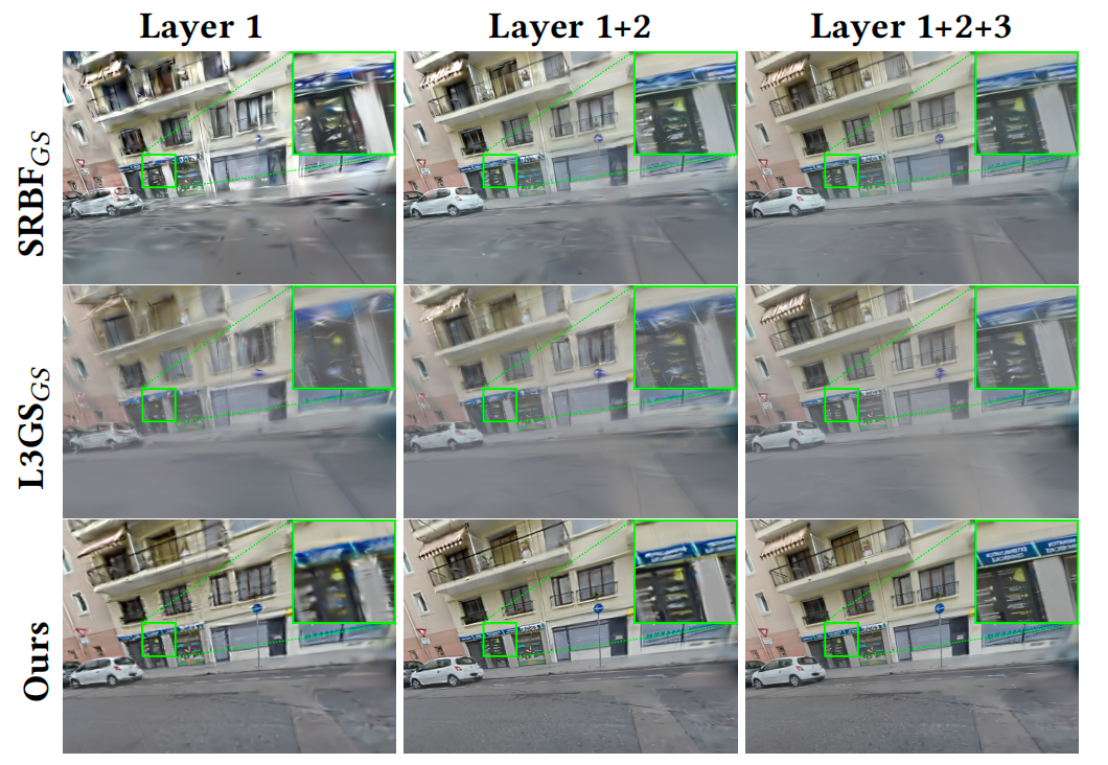 场景分层效果示例
预判需求:视角预测有偏差,也能准备正确的内容
在三维空间中,要准确预测使用者未来的位置和朝向并不容易。通常,预测窗口越长,不确定性越大。但研究团队发现:即使预测位置不够准确,预取的场景内容也不一定会错。
例如,在同一条道路上,两个存在一定偏差的预测位置,仍可能需要相同的一组空间单元。场景中的道路走向、拐角与遮挡,也会影响使用者能够到达的位置和看到的内容。
基于这一观察,Toruk 提出了一套场景感知的视角预测流程:系统将不同位置和朝向误差范围内的预测结果转化为预取权重,再结合区域间的遮挡关系、观察距离和视野覆盖比例,评估各个空间单元的视觉重要性。系统重点判断哪些区域未来可能进入视野、它们对画面的贡献有多大,以及哪些内容值得提前准备。
这种设计让预测结果与实际传输需求联系得更加紧密,也将场景本身的几何结构成为优化内容预取的重要依据。
工业环境同样具有丰富的空间约束:通道连接着不同设备区域,建筑会形成遮挡,巡检路线往往也具有一定的规律。未来,还可以结合任务路线和关注区域,进一步探索面向具体工作流程的场景预加载,让数据到达的顺序更贴近实际使用需求。
持续调度:看清眼前,也为下一步做好准备
三维漫游还有一个特殊之处:缓存数据的多少,并不能直接决定场景还能流畅显示多久。使用者停下来观察时,已缓存的区域可能持续满足需求;如果使用者突然快速前进或突然转向时,系统则需尽快准备新的内容。
论文将这种有效时长取决于未来行为的缓存称为 “薛定谔式缓存”。
针对这一问题,Toruk 分别处理基础层与增强层的需求:提前预取新区域的基础内容,并在较短的预测窗口内调度增强层内容。
在此基础上,研究引入了跨时间、跨空间的因果序列模型,该模型综合历史状态、传输动作、网络带宽与缓存情况,选择不同区域的增强层请求,在当前观看质量与后续访问需求之间动态分配资源。
使用者停下来仔细观察时,补充当前区域的细节更有价值;使用者继续移动时,系统需要为前方场景留出传输资源。
通过持续调整,场景表示、内容预取和网络调度得以协同工作:数据按空间结构组织,围绕访问行为提前准备,再结合网络条件逐步传输,最终到达。
在大规模场景与动态网络下改善交互体验
研究团队基于Unity构建了端到端原型,并在约4万平方米的城市场景 SmallCity 和 5.5万平方米的校园场景Campus中开展评估,测试中,团队回放固定宽带与 5G 的真实网络吞吐轨迹,以检验系统在不同场景、用户行为和网络条件下的表现。
论文报告的主要结果如下:
· 场景表示的 PSNR 平均提升 2.2 dB,反映出重建画面质量有所改善。
· 下载超时惩罚平均降低 67.5%,表明增强内容未能及时到达所带来的体验损失有所减少。
· 综合体验指标QoE平均提升 36.3%,更好地平衡了观看质量与传输效率。
这些结果表明,通过联合优化场景表示、内容预取和传输策略,大规模三维实景在动态网络条件下能够实现更好的交互体验。
三维场景是否好用,既取决于空间内容能否及时到达,也取决于场景本身是否清晰。
让真实场景成为可以持续利用的数据资产
对物理 AI 而言,真实环境数据承载着设备布局、空间关系与现场工况等重要信息。将这些信息保留在三维空间中,可以为环境观察、任务复盘和虚拟推演提供基础。随着场景资产不断积累,如何让这些资产在不同地点和网络条件下都能有效使用,也成为数据基础设施需要解决的问题。
江行智能的 JX-Phi World 汇聚工业实景、端侧真机与虚拟推演数据,为物理 AI 模型持续学习与迭代提供支持。其中,AutoWorld 面向真实场景重建与仿真开展环境生成,AutoEdge则连接工业现场与云端算力。实景数据从现场进入数字环境后,还需要经过组织、交付与使用,才能在更多环节发挥价值。Toruk为其中的大规模空间内容交付提供了具体探索。
从真实采集、三维重建,到网络交互与场景复用,每一个环节都在影响环境数据能够发挥多大的价值。Toruk 推进了其中关键的一步:让真实世界的三维表达能够跟随交互需求,支持连续访问、细致观察和有效使用。
江行智能将持续围绕世界模型、空间智能与基础设施开展研究,推动真实环境数据更充分地服务于模型学习与应用迭代,为物理 AI 在现实世界中的可靠执行提供支撑。
Toruk: Spatially Adaptive Large-Scale 3DGS Scene Streaming for Photorealistic Interactive Virtual Walkthrough.
会议:ACM Multimedia 2026 Oral
作者:Jianxin Shi、Tianshun Cai、Sijie Zhou、Xiaoyi Fan、Cong Zhang、Danyang Song、Yuan Zhang、Lingjun Pu、Jiangchuan Liu