“识别”能力趋近成熟,为什么物理AI还有那么多事要做?
先做一个实验。
你把手机摄像头对准厨房的水龙头,相册里的AI瞬间弹出一个框:水龙头,置信度98%。
这说明什么?说明你的手机“认识”水龙头。
但如果需要指挥一个机器人拧开,手机能告诉我们怎么做吗?——它知道这玩意儿叫水龙头,却不知道该用多大劲儿、往哪个方向拧、拧到什么程度算到位。
在手机AI眼里,水龙头是一串像素、一个分类标签。在机器人眼里,水龙头是一个需要上手操作的物理对象:它的材质是金属还是塑料、螺纹是紧是松、拧三圈还是拧五圈才不漏水。
手机要告诉你:“这是水龙头。”
机器人要回答另外三个问题:“它在哪?我怎么够到它?我该用多大的力?”
这就是“识别”和“操作”之间最本质的差距——一个只需要眼睛,一个需要手、脑、身体的完整配合。从看见到做到,隔着三座大山。
试着回忆你拿起水杯喝水的过程。
眼睛看到杯子→大脑判断它的位置→手臂规划出一条轨迹→手指施加恰到好处的力度→握住→抬起→送到嘴边——期间如果杯子比想象中沉,肌肉会自动加大力量;如果杯壁很滑,手指会自动收紧。
整个过程,你的大脑在几十毫秒内完成了感知、决策、执行、反馈的完整闭环,而你毫无察觉。
机器人要做到同样的事,需要翻越三座大山:
第一座:空间感知。 杯子在哪里?以什么角度摆放?表面材质是什么?——这需要视觉、深度传感器、点云数据的融合。
第二座:运动规划。 手臂从哪里出发?路径会不会撞到别的东西?以什么姿态接近杯子?——这需要动力学计算。
第三座:物理交互。 该用多大的力?抓哪里最稳?抓起来之后杯子会不会滑?——这需要力控和触觉反馈。
第一座山,巡检机器人爬了8年,现在已经很成熟。第二座山,无人驾驶和移动机器人爬了一半。第三座山,是这段时间的真正分水岭。
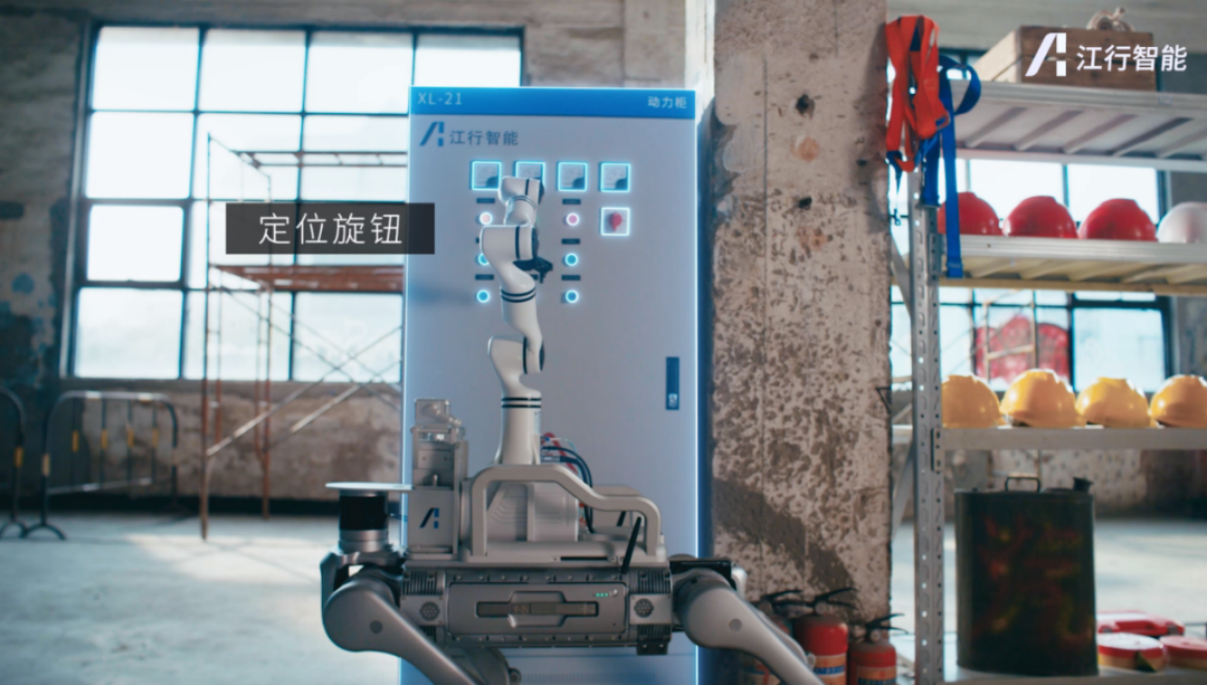 拧一个旋钮,看起来比开车简单得多。但对机器人来说,用多大的力去拧比怎么走到旋钮面前难一个数量级——因为力度控制涉及的是机器人对外部物理世界的实时反应,而不是靠预先写好的程序就能解决。
这就是为什么市面上很多机器人“会走、会看、会绕障”,但真正能上手干活的,寥寥无几。
为什么不能给它装一个“云端大脑”?
那你可能会问:现在大模型这么强,让机器人连上云端,让AI在后台替它思考,不就行了?
理论上可以。但现实中有一个致命问题:网络会断,会有延迟。
在工业现场——一座变电站、一个化工园区、一条地下管廊——网络环境远比办公室复杂。信号不稳定、带宽有限、延迟不可控。如果机器人的每一个动作都要等云端“思考”完后回传,一旦网络抖动,它就会停在原地,变成一座昂贵的雕塑。
更关键的是,工业现场的很多操作是有黄金窗口期的。设备出现异常,必须在几秒内完成判断和处置。等不起一个网络往返。
所以,真正能干活儿的机器人,大脑必须装在身体里——“端侧部署”,不靠云端救场,所有计算在本地完成。
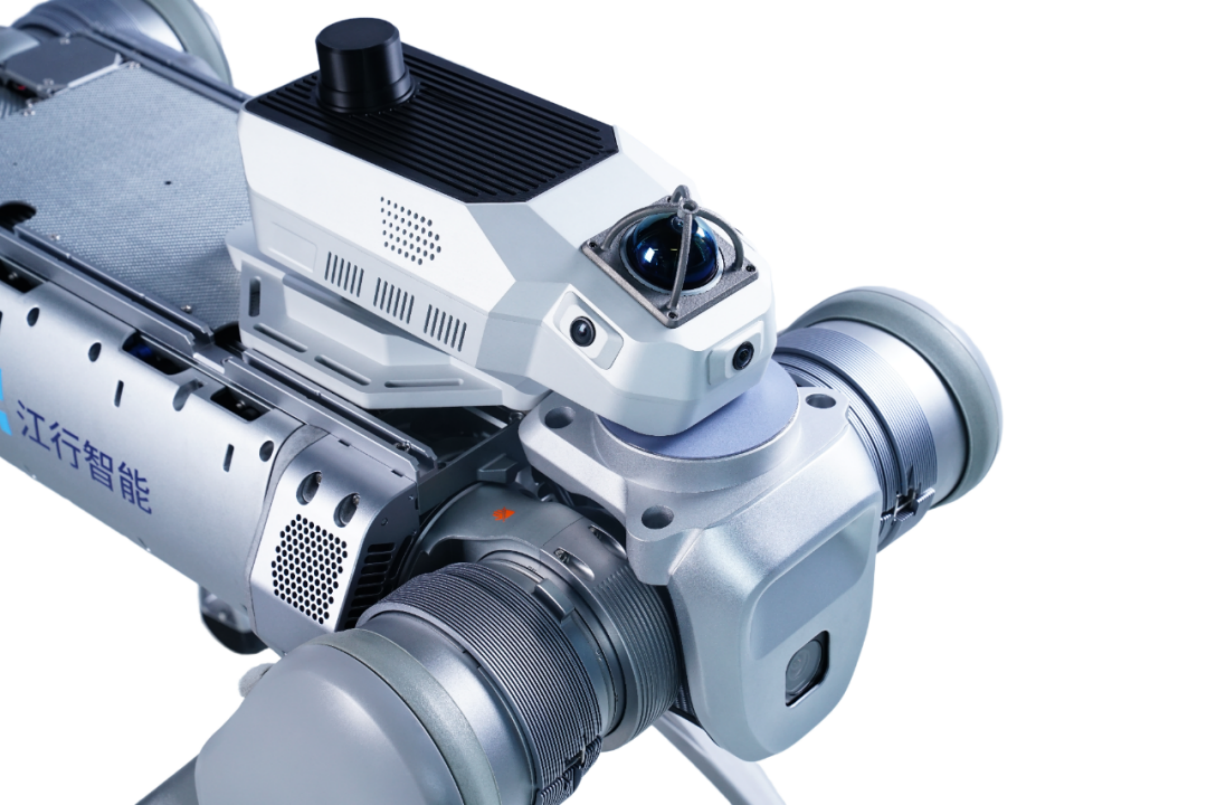
就像你在现场处理紧急情况时,不可能掏出手机打电话问别人我该怎么办,你得自己判断,自己出手。
这是一个朴素的道理,但它是物理AI和普通联网设备之间最本质的区别。
一个机器人的“手工课”是怎么上的?
说了这么多原理,来看一个具体的例子。
江行智能的具身机器人「擎巡X1U」,长着一只机械臂。
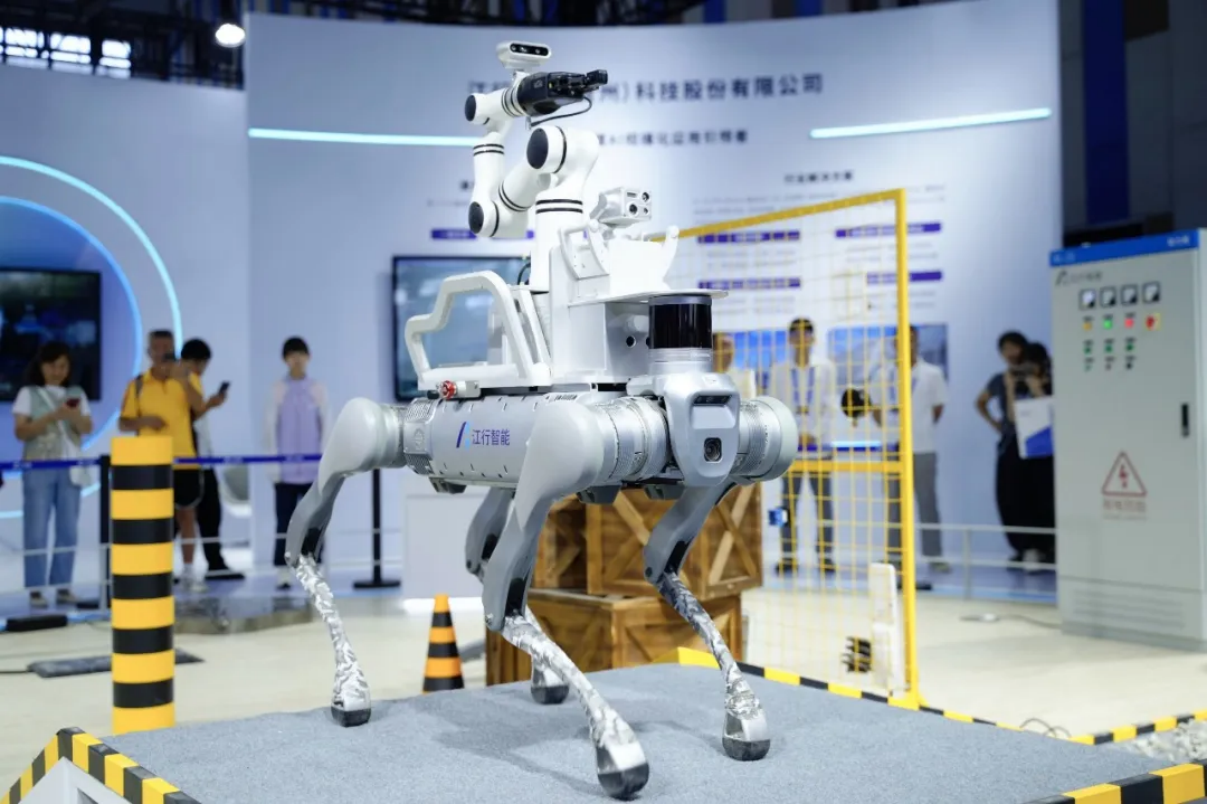
在一次实际作业中,它走到一个动力柜前,要完成一个旋钮复位操作。整个流程是这样的:
第一步,视觉系统锁定旋钮的位置,确认它需要复位;第二步,机械臂规划路径,避开柜体边缘,对准旋钮;第三步,施加适当的力度旋转旋钮——不能太轻,会打滑;不能太重,会损坏设备;第四步,退开一步,二次确认旋钮是否真的复位成功。
看,这和我们人类拧螺丝的过程一模一样:看准、握住、对准、用力、拧紧、再确认一下。
但每一步背后,都有一套计算在跑。尤其是力度控制这一步——机器人要在接触旋钮的瞬间,“感受”到阻力变化,实时调整输出力矩。这需要的不是“识别能力”,而是“物理理解能力”。
再举一个更容易忽略的例子:具身机器人 擎巡X1U在行进途中遇到一片水洼。
它没有直接趟过去,而是停了一下,绕开了。
注意,这不是“识别到障碍物然后避障”——这是它结合地形、积水深度、自身负载和作业目标,判断出“直接通过可能有风险,绕行更安全”。
“看见”障碍物,是感知;“理解”风险并做出决策,是智能。
这两者之间的差距,正是“自动化设备”和“物理AI”的分界线。
写在最后
回到文章开头的问题。
为什么你手机里的AI能认出水龙头,却拧不开它?因为它只有“识别”,没有“理解”,更没有“操作”。
但当机器人集齐感知、理解、决策、执行这四块拼图——它能绕开水洼,能拧紧旋钮,能在设备间完成一次完整的物理操作——它就从一个观察者,变成了一个参与者。
机器人学会干活,和人学会干活,本质上没有区别:在真实世界里,反复练习,持续进化。
而这,正是物理AI正在做的事。